ABC Legal 图解:1100 人公司的全员 Agent 舰队
一家美国法律文书送达公司,把「建 agent」这件事从 dev 团队下放给了财务、市场、运营的普通员工。三个月内 50+ 个 agent 跑进生产环境。支撑它的不是什么新技术,而是三件旧东西的组合:git 仓库、pull request、Slack 里的 emoji。
一、他们是怎么走到这一步的
故事有一个反直觉的开头:CTO Brandon Fuller 什么都没要求,员工就自己动起来了。Claude Enterprise 铺开后,各个团队自发用 connectors 和 tools 自动化「一直吃掉自己时间」的琐事。问题出在下一层——这些早期 agent 是个人桌面上的定时任务:不能无人值守、没有统一视图,没人知道建了什么、花了多少钱、昨晚跑没跑。
ABC Legal 在 Managed Agents 刚进 beta 时先自建了一轮 scheduled tasks 和本地 routines——后来全部迁走。他今天的建议:跳过这个弯路,直接上托管平台。
二、Agents as Code:agent 住在仓库里
整个体系的地基是一句话的洞察:agent 就是结构化文本——prompt 加配置。是文本,就能进仓库;进了仓库,版本历史、代码评审、回滚、审计轨迹就全部免费到手。agent 的 prompt、工具列表、schedule、凭证、memory 全在配置文件里,没有任何变更能绕过 pull request。
推论是把 PRpull request:Git 的「提议变更 + 逐行评论 + 审批合并」机制。文中非开发者最初把它理解成跑步用的「配速(pace run)」。 用作一切决策的控制面:
「如果你想让 agent 参与一个决策,就把这个决策做成 pull request。」——Brandon Fuller
逐行评论、审批工作流、不可变审计轨迹免费来自版本控制,且天然兼容「AI 先审、人再合」。后续会看到:连「agent 改进 agent」也走这条通道。
三、非开发者的一周
Fuller 拉来公司 15 人的 steering committee——来自财务、市场、运营、开发,没有一个软件工程师——让他们 clone 仓库、用 Claude Code 建生产级 agent。动机很清楚:如果每个 agent 都要过 dev 团队,这个瓶颈会封顶全公司的速度。安全性也清楚:他们写的不是软件,是配置和 prompt;运行时runtime:执行循环、容器、session、模型——全部由 Claude Managed Agents 托管提供,builder 不碰。由平台提供。
四、舰队全景:一条业务流程,一串 agent
ABC Legal 的主营业务是法律文书送达与立案。把业务流程摊开,几乎每个阶段都站着一个 agent:
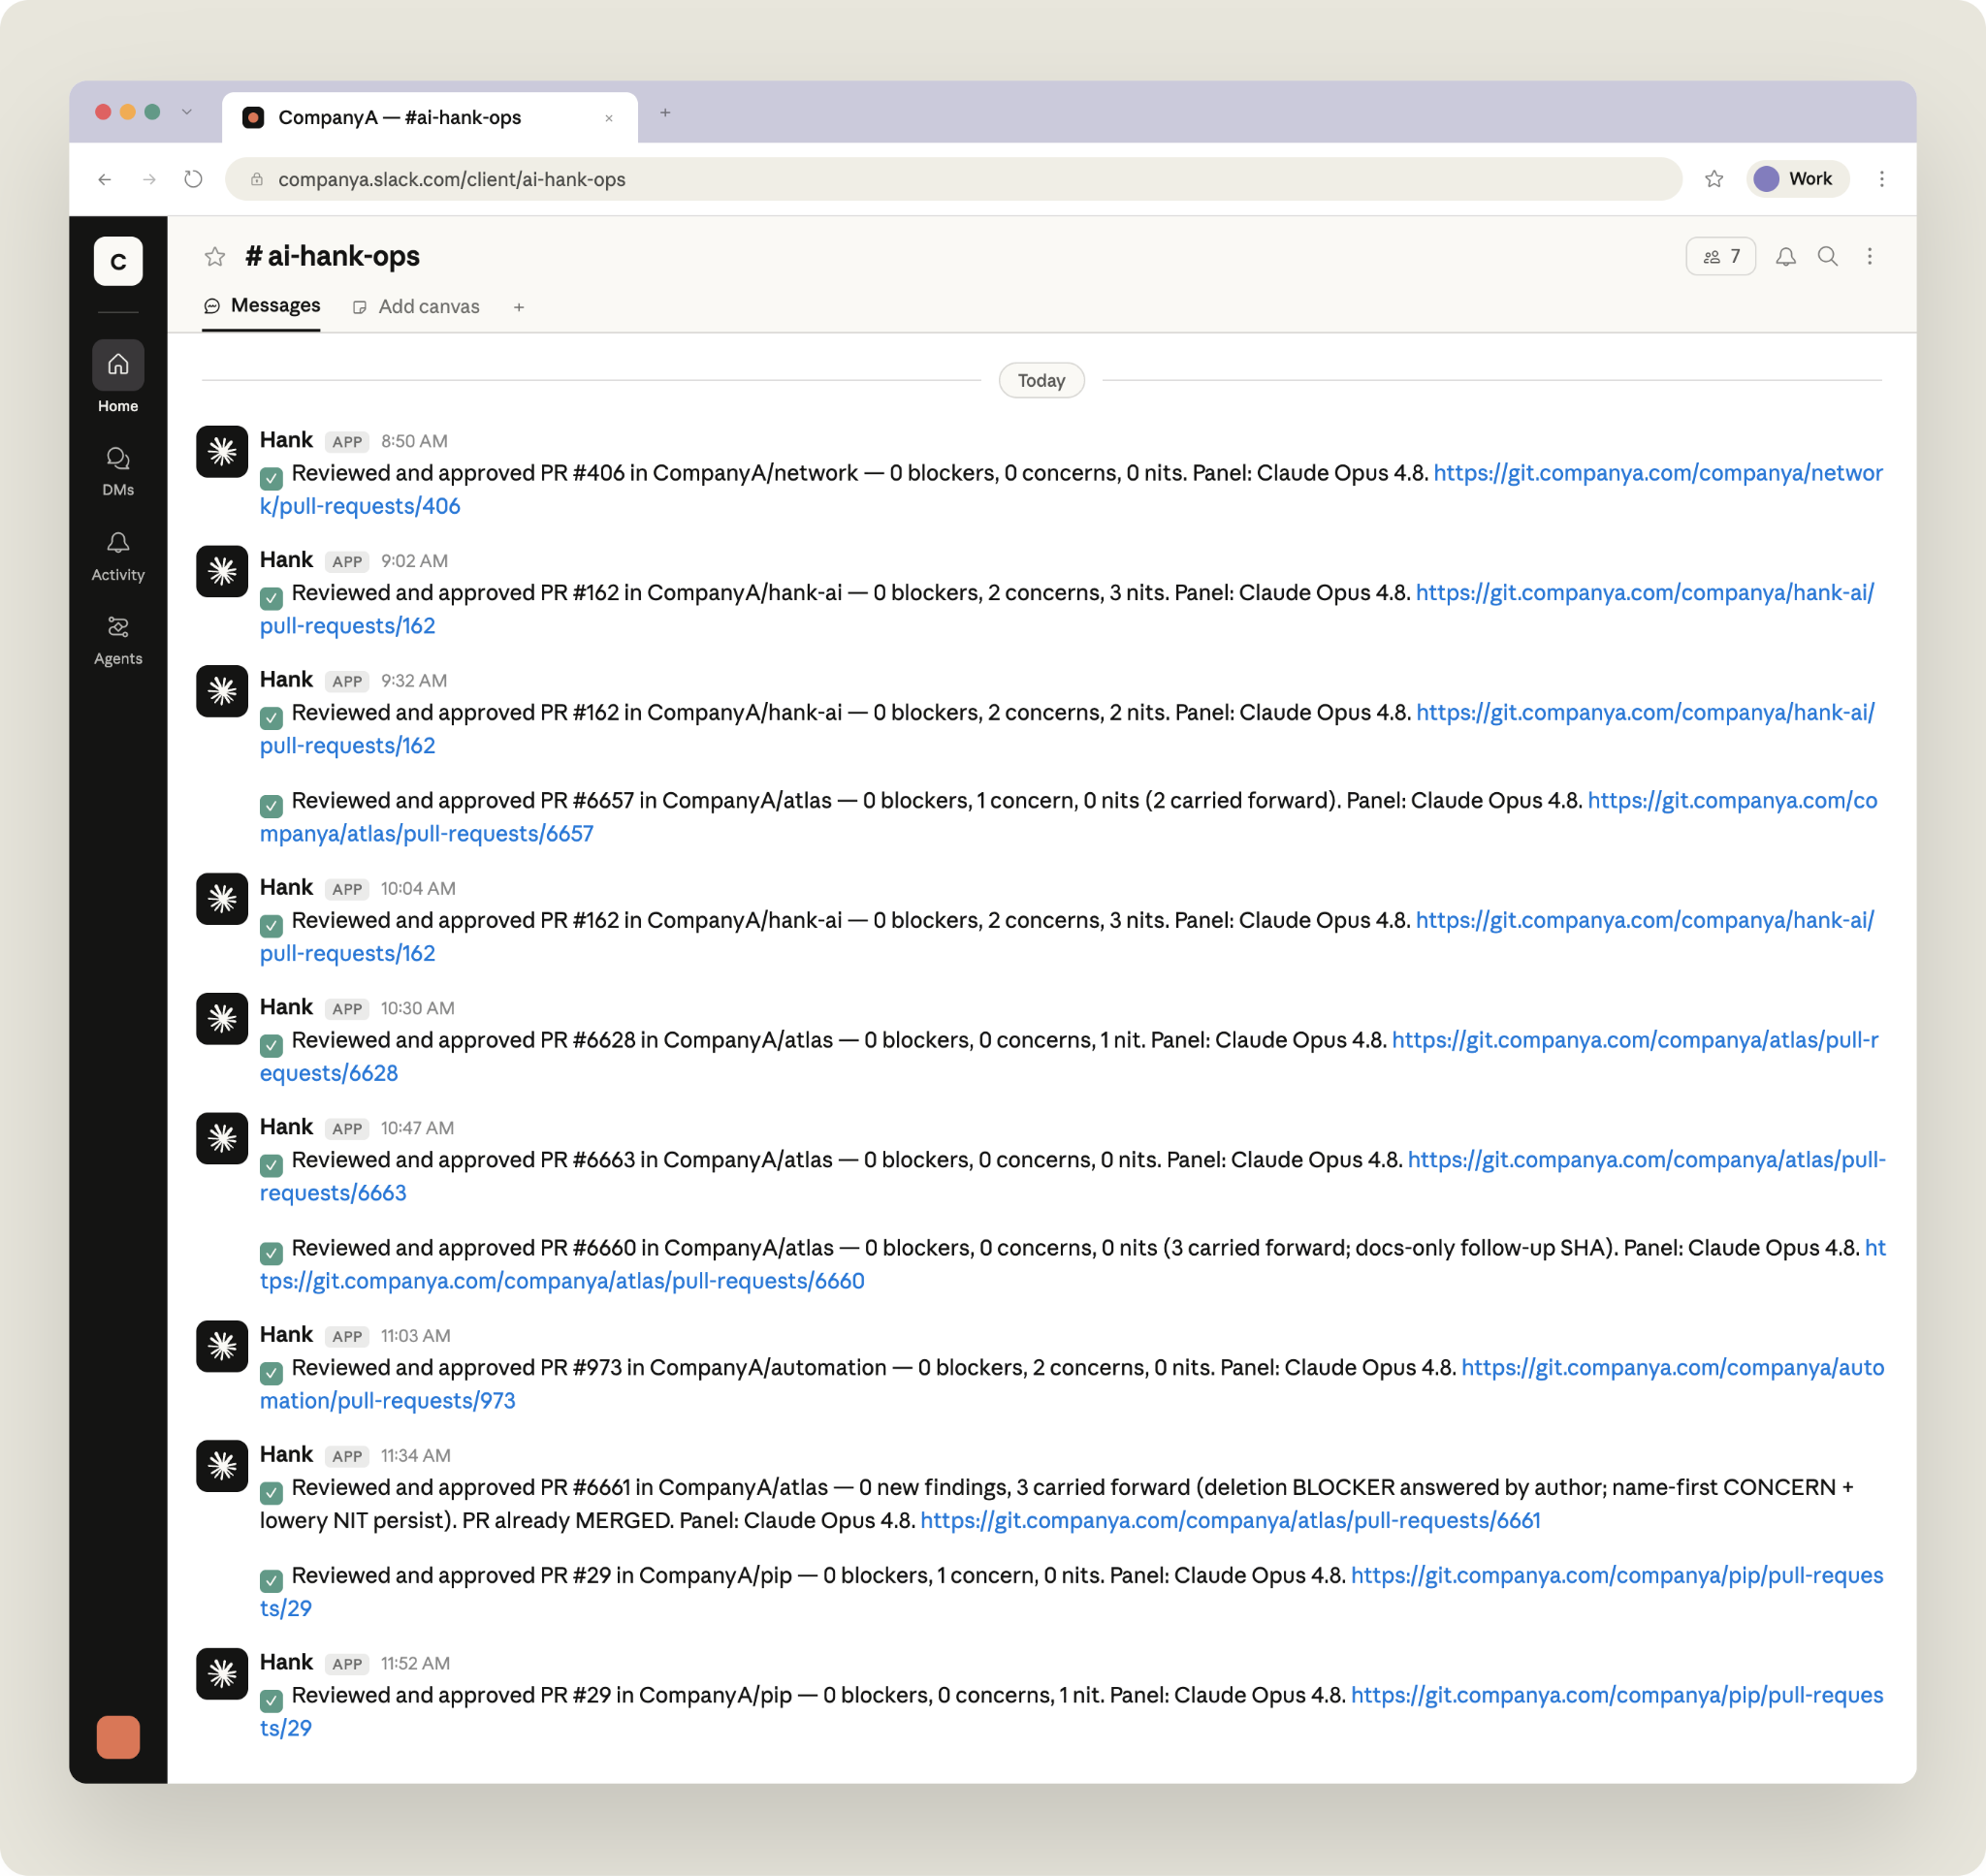
看一眼 Hank 在 Slack 上的样子
五、Harvester-Tuner:emoji 怎么变成 PR
所有 agent 在人类监督下工作:把做了什么/建议什么发到 Slack,人们在线程里回复、用 emoji 反应。Fuller 的观察是——这些反应数据是被浪费的训练信号。对输出会被持续评价的 agent,ABC Legal 用三个共享 workspace、凭证库但调度各异的专职 agent 组成一个自改进循环:
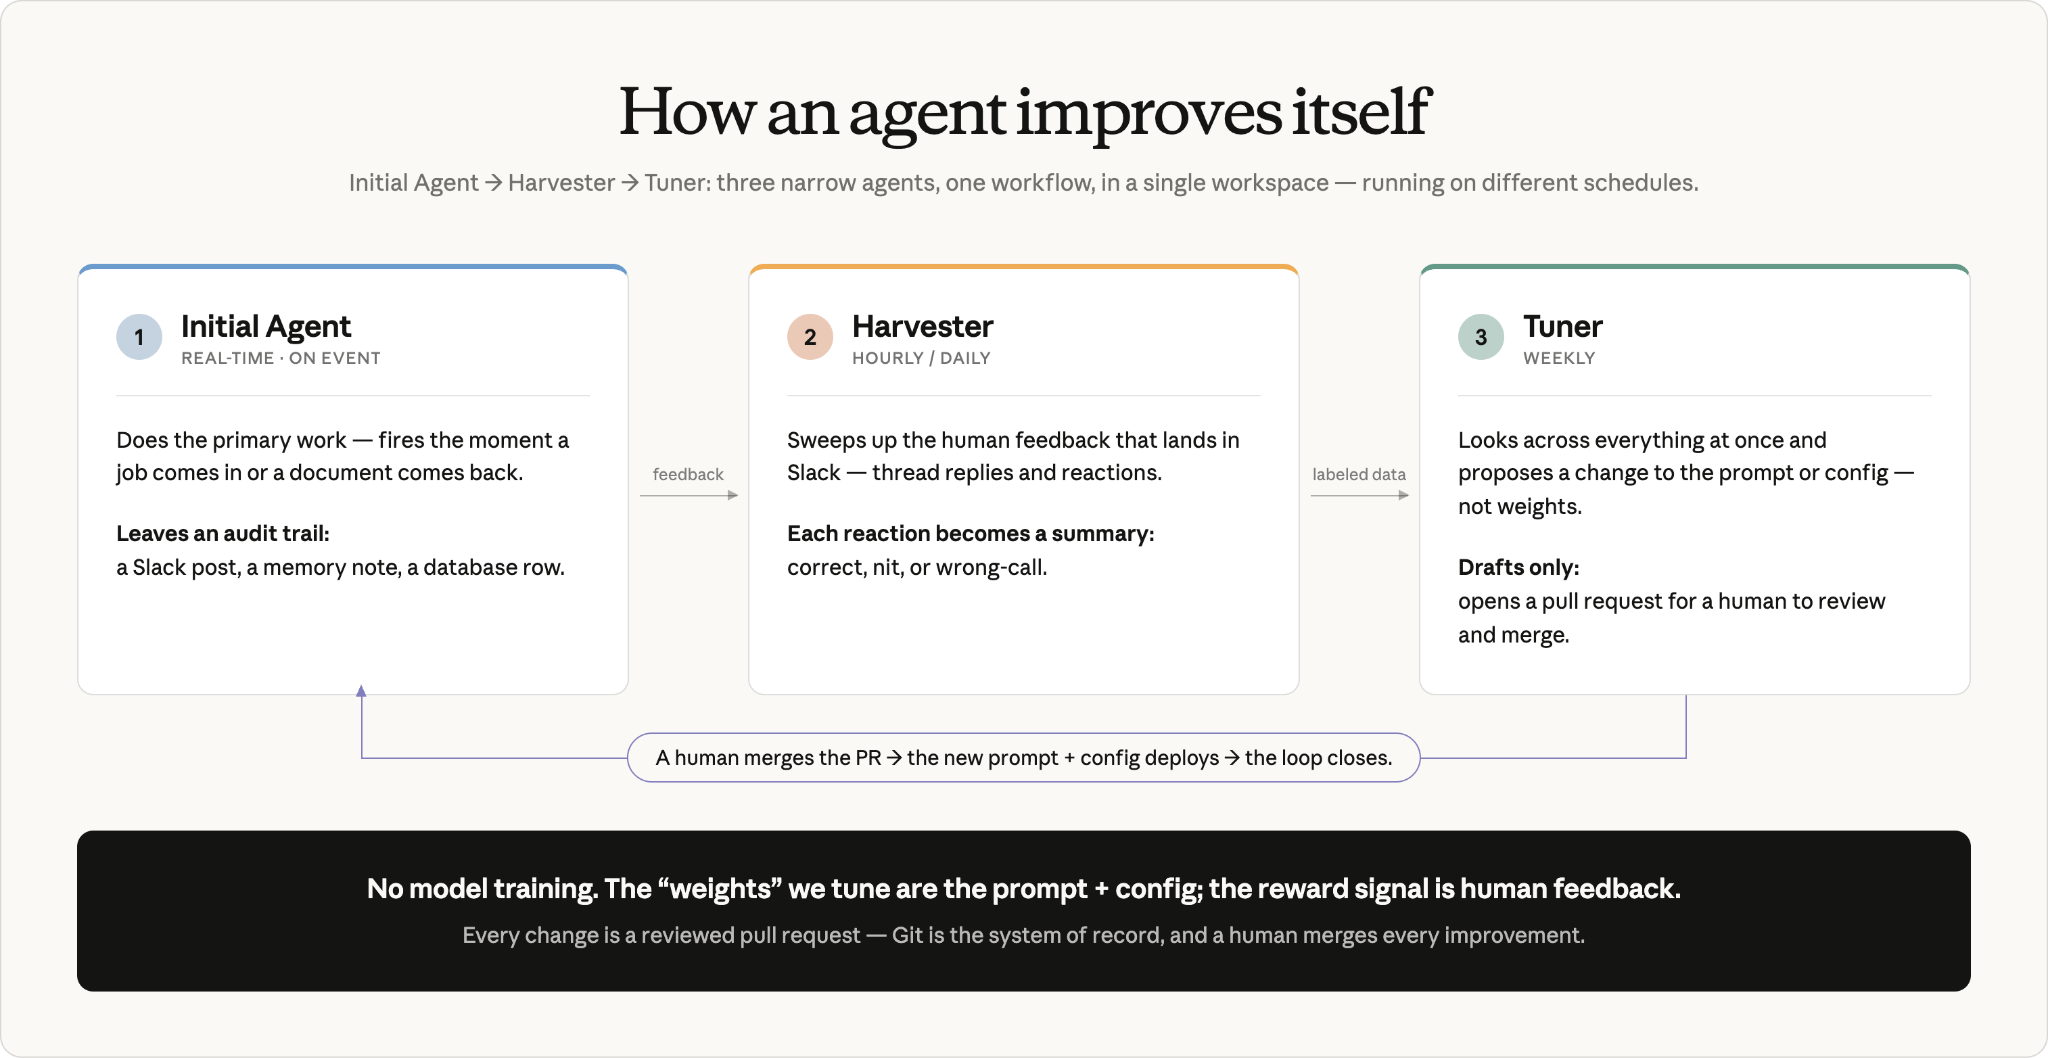
循环的三步:① Initial Agent 实时干活并留审计轨迹(Slack 消息 + memory 笔记 + 数据库记录);② Harvester 每小时/每日收割 Slack 反馈,线程回复和 emoji 反应各成一个标注数据点;③ Tuner 每周全盘审视,起草 prompt/config 变更的 PR——只起草,人类审查合并。
「无模型训练。我们调优的『权重』是 prompt + config;奖励信号是人类反馈。」——把 RL 里最贵的部分(奖励模型、训练管线)整个外包给了已有工作流:Slack emoji 是奖励信号,PR 评审是安全门,Git 是 system of record。
最完整的实例是姊妹公司 Docketly 的「deliveries-as-code」:约 145 个 delivery 路由规则全部是 git 里的单个 YAML 文件(而非管理后台的数据库记录),由四个 agent 构成闭环:
边界同样重要:不是每个 agent 都需要这个循环。舰队里大多数是单任务 runner,输出没人打分,独自工作就好。反馈环只挂在「输出被人类持续评价」的 agent 上。
六、信任是挣来的:从建议到自主
成本策略与信任策略是同一条阶梯。支出被刻意推向回报可度量的垂直运营 agent,横向聊天/ideation 保持广用但控成本。而每个 agent 沿同一条路径升级:
七、效率比与 J 曲线
度量只有一个数:效率比——agent 交付的价值 ÷ 运行成本。每个 agent 每次运行把价值(小时 + 美元)报回数据仓库,按 vendor / tool / team / use case 拆到每一美元。agent 的生命周期因此呈现 J 曲线:
模型分层是 J 曲线的第一杠杆:Sonnet 是默认,Haiku 接高频快任务,Opus 只在深推理值回票价时用——换模型是一行改动(agent 本来就是配置文件)。
八、七条最佳实践,一张表带走
| 原则 | 一句话 |
|---|---|
| 一切当代码 | 「代码只是结构化文本,LLM 是文本引擎」——业务文本化进 repo 的比例,决定 agent 杠杆的上限(prompt、schema、dispatch 规则、通知模板都算) |
| 从人在环中起步 | agent 先发建议,与人类决策持续一致后才挣得独立行动权 |
| PR 是控制面 | 想让 agent 参与决策,就把决策做成 PR——逐行评论、审批流、审计轨迹免费自带 |
| 投资反馈环 | Harvester-Tuner 让 agent 无需 retraining 就改进;Slack 回复和 emoji 变成结构化信号 |
| 跳过定时任务弯路 | 别先自建 scheduled tasks / 本地 routines,直接上托管平台 |
| 预期 git 门槛 | 最难的不是 AI,是让业务用户学会 clone 仓库和 pull request |
| 不是每个任务都配 agent | 成本真实存在,按价值/成本筛选,敢说「这个任务不值得」 |
下一步的清单还在变长:service photo reviewer、PagerDuty triage、daily KPI digest、既有 agent 扩展 Tuner 循环,以及更多「X-as-code」候选——通知模板、事件路由规则、dispatch 逻辑。Fuller 的愿景收在一句轻描淡写里:
「我们要 AI 支撑一个能自己运转的业务,员工自由地去掌舵。」